

MOSS-Imageという新しい画像生成AIがローカル環境でもリリースされました。ChatGptのようなテキスト入りの画像は生成できるのか?実際に試してみました。
また、今回はこれまで面倒に感じていたこういう新しいAIツールの導入作業を、どこまで任せられるのかも試しています。
MOSS-Imageとは?
MOSS-Imageは、オープンソースとして公開されている画像生成モデルです。今回注目したのは、画像の中に文字を描画する能力と、レイアウトを指定できる点です。
一般的な画像生成AIでは、指定した文字が崩れたり、余計な文字が混ざったりすることがあります。日本語のタイトルを正確に描画できれば、ブログのアイキャッチ制作を効率化できるかもしれません。
そこで今回は、実際に日本語のタイトルを指定して、どこまで使える画像ができるのか検証してみます。
公式サイト:
- GitHub:https://github.com/OpenMOSS/MOSS-Image
- Hugging Face:https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT
CodexにMOSS-Imageの環境構築を任せてみた
今回の実験環境は次のとおりです。
- GPU:GeForce RTX 5060 Ti 16GB
- ComfyUI:Stability Matrix経由で導入
- モデル保存先:Stability Matrixとは別ドライブ
これまでは、ローカルAIを使おうとすると、モデルを探して、必要なファイルをダウンロードし、指定のフォルダにおいて……と、簡単ではあるものの地味に手間がかかっていました。
そこで今回は、Windows版ChatGPTアプリからCodexを使ってみることにしました。Codexに伝えたのは、こんな感じです。
MOSS-Imageっての使いたいんだけど環境って整備できる?
Stability MatrixでComfyUIは導入済み。モデルはFドライブに置いてる。
かなりざっくりした指示です。
それでもCodexはPC内の環境を調査し、ComfyUIのバージョンを確認。公式モデルや必要なファイルを配置し、ノードとワークフローの導入まで進めてくれました。
作業時間は約15分。
最終的には、Stability MatrixのLatestComfyUI環境にMOSS-Image-SFT用のワークフローが用意され、実際に画像を生成するところまで確認できました。
正直、ローカルLLMでできなかったことが簡単にできてしまいました。やっぱりローカルAIとクラウドAIには現時点ではかなりの差があるなと痛感。
しかし、気になるのは利用制限
Codexの場合月間利用制限という項目があり、導入後に確認したところ、100%→90%になってました。この作業で10%。無料枠でも結構使えるな、といった印象でした。
もちろん、色々やらせてしまうと無料枠ではあっというまに使い切ってしまうでしょう。ただ使い方を工夫すればアリだな、と感じました。それころローカルAIもうまく使ったりしてね。
Codexによる作業が気になる方は、公式ページも確認してみてください。Web経由でChatGptを利用しているのであれば、アプリをダウンロードしてインストールしたら、そのアカウントでログインするだけですぐ使えます。

MOSS-Imageで日本語入りのアイキャッチを生成
環境が整ったので、さっそく画像を生成してみます。今回作りたかったのは、ローカルAIをテーマにしたブログのアイキャッチです。
タイトルは「ローカルAIをもっと楽しむ」。
左側に大きなタイトル文字を配置し、右側には紫色の髪と猫耳が特徴のAIキャラクターを置く構図にしました。プロンプトでは、背景に未来的なPC環境や紫色の光を指定。文字の内容、配置、配色についても具体的に指示しています。
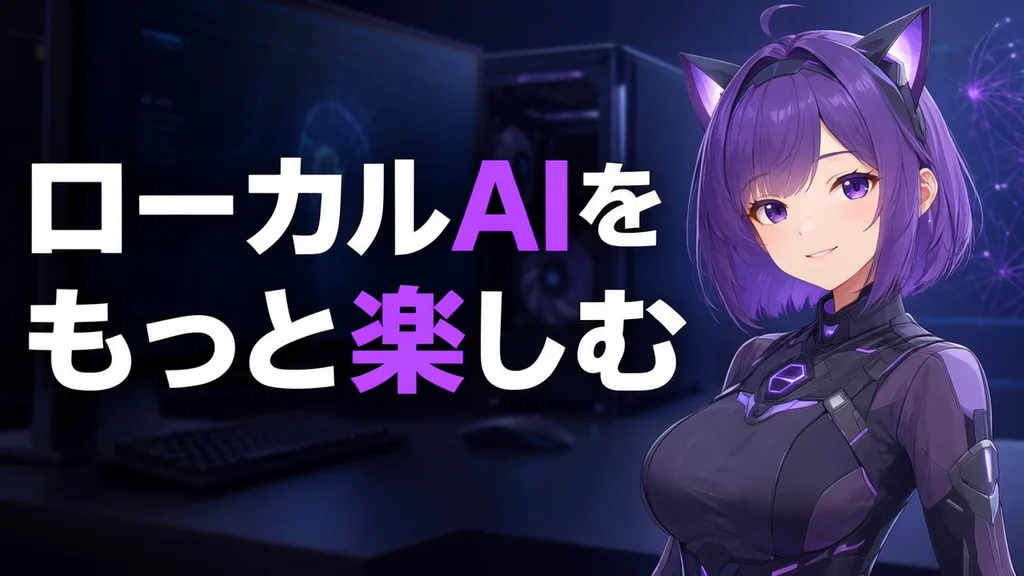
生成された画像を見ると、日本語のタイトルはかなり正確に描画されています。
「ローカルAIをもっと楽しむ」という文字が崩れず、指定したとおりに2行で配置されました。文字の一部が紫色になっている点も、全体のデザインに合っています。
キャラクターは右側、タイトルは左側という構図も意図したとおりです。
少なくとも今回の生成結果を見る限り、日本語の文字を含むアイキャッチを作る用途には十分可能性を感じました。
プロンプトを工夫すれば、もっと高品質になる?
ここで気になったのが、ChatGPTの画像生成で作るような、背景や光の演出まで作り込まれたアイキャッチを作れるのかという点です。
そこで、2回目はプロンプトを変更してみました。
単に背景やキャラクターを指定するだけでなく、次のような要素を追加しています。
- 映画のようなライティング
- 奥行きのある未来的なデジタル空間
- 髪や衣装に反射する紫色の光
- 雑誌の表紙のような文字配置
- 背景とキャラクターが一体化した構図
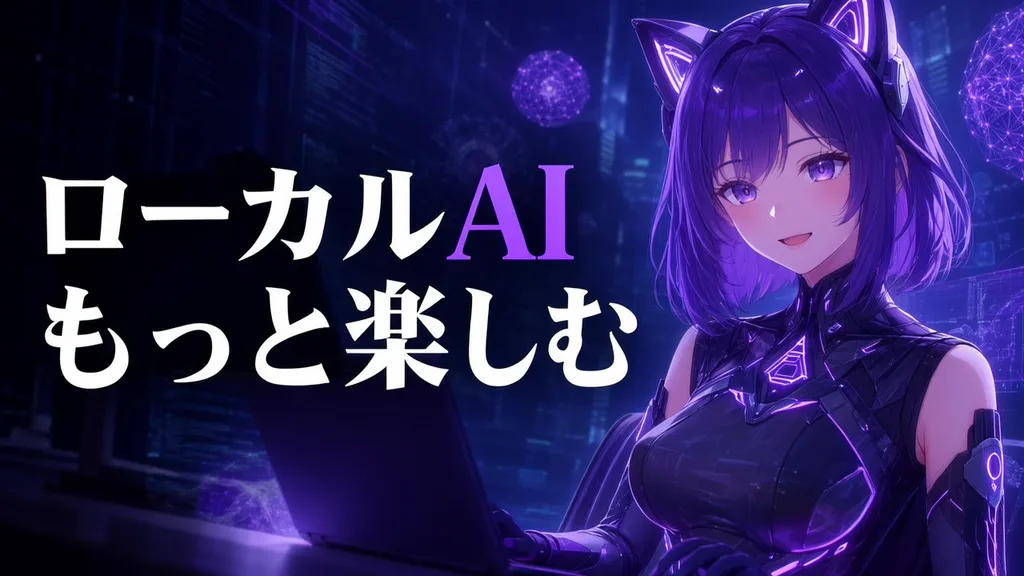
結果はどうだったのか。残念ながら、プロンプトを詳しくした割には、最初の画像から劇的に変わったとは感じませんでした。
日本語の文字は引き続ききれいに描画されましたが、ビジュアルの印象を大きく変えるところまではいきませんでした。
もちろん、今回の試行だけでMOSS-Imageの表現力を判断することはできません。プロンプトの書き方だけでなく、モデルの特性やワークフロー、生成設定なども影響するはずです。
ただ、少なくとも今回の実験では、指示を詳しくするだけで期待どおりの高品質な画像になるわけではありませんでした。
MOSS-Imageはブログのアイキャッチ制作に使える?
今回の結果を整理すると、次のようになります。
| 項目 | 今回の評価 |
|---|---|
| 日本語タイトルの描画 | かなり良好 |
| 文字とキャラクターの配置 | 指示どおりに生成できた |
| プロンプトによる演出の変更 | 期待したほど大きな変化はなかった |
| ブログのアイキャッチへの利用 | 十分試す価値あり |
特に印象的だったのは、日本語のタイトルを含む画像を、別のツールで文字入れすることなく生成できた点です。
ただし、今回の結果だけで、長い日本語タイトルでも常に正確に描画できるとは言い切れません。記事ごとにタイトルの長さも異なるため、実際に使う場合は生成画像の確認が必要です。
また、ビジュアルの完成度については、今後さらに検証する余地がありそうです。
例えば、別の画像生成モデルで背景やキャラクターを作り、文字の配置は別工程で調整する方法も考えられます。
一発生成にこだわるよりも、それぞれのモデルの得意分野を組み合わせたほうが、実用的な制作フローになるかもしれません。
まとめ
今回はMOSS-Image-SFTをComfyUIで動かし、日本語タイトル入りのブログアイキャッチを作ってみました。
日本語の文字はかなり正確に描画され、タイトルとキャラクターを組み合わせた画像を生成できました。一方、プロンプトを詳しくしても、ビジュアルの印象は期待したほど変わりませんでした。
そして、もうひとつ大きな収穫だったのが、Codexによる環境構築です。
これまで手作業で調べていたモデルやノードの導入を、AIエージェントにかなりの部分まで任せられました。
ローカルAIは、モデルを動かすまでの準備が大変という印象がありましたが、その部分も少しずつ変わってきているようです。
MOSS-Imageについては、Open WebUIで使用しているローカルLLMからも使用できるようにして、実際のブログ制作のアイキャッチ画像を生成できるようにしてみるつもりです。
日本語入りの画像をローカル環境で生成したい方は、一度試してみる価値があるモデルだと感じました。
コメント