

はじめに
ローカルLLMやローカル環境で動くAIエージェントをいろいろ試していいました。
自分のPCでAIを動かせれば、利用料金を気にせず実験できるし、画像生成や音楽制作などにも活用できますしね。うまく環境を構築すれば、AIエージェントにさまざまな作業を任せられるのではないか、とそんな期待もありました。
しかし、最近は少し考えが変わってきました。
ローカルAIは、思っていたほど実用的なのだろうか?
と。今回は、CodexとローカルLLMを使った実体験をもとに、ローカルAIの可能性と限界について考えてみました。
Codexに画像を再現するプロンプトを作ってもらった
きっかけは、ブログのアイキャッチ画像でした。
ChatGPTで生成した画像を、先日発表されたMoss Imageでも再現したいと思い、実際に試してみました。
Moss Imageを導入した際に書いた記事はこちら。
そこで最近使いだしたCodexに、ChatGptで作成した画像を参考として渡してMoss Imageで「これを再現できるプロンプトを出して」と依頼しました。
すると、返ってきたのは単なる文章のプロンプトではなく、JSON形式で、画像を構成する要素が細かく整理されていました。
- ブランド名やキャッチコピー
- メインタイトルの文字列と配置
- 文字の色や装飾
- キャラクターの外見と配置
- 背景のソフトウェア画面
- 下部の補足情報や装飾
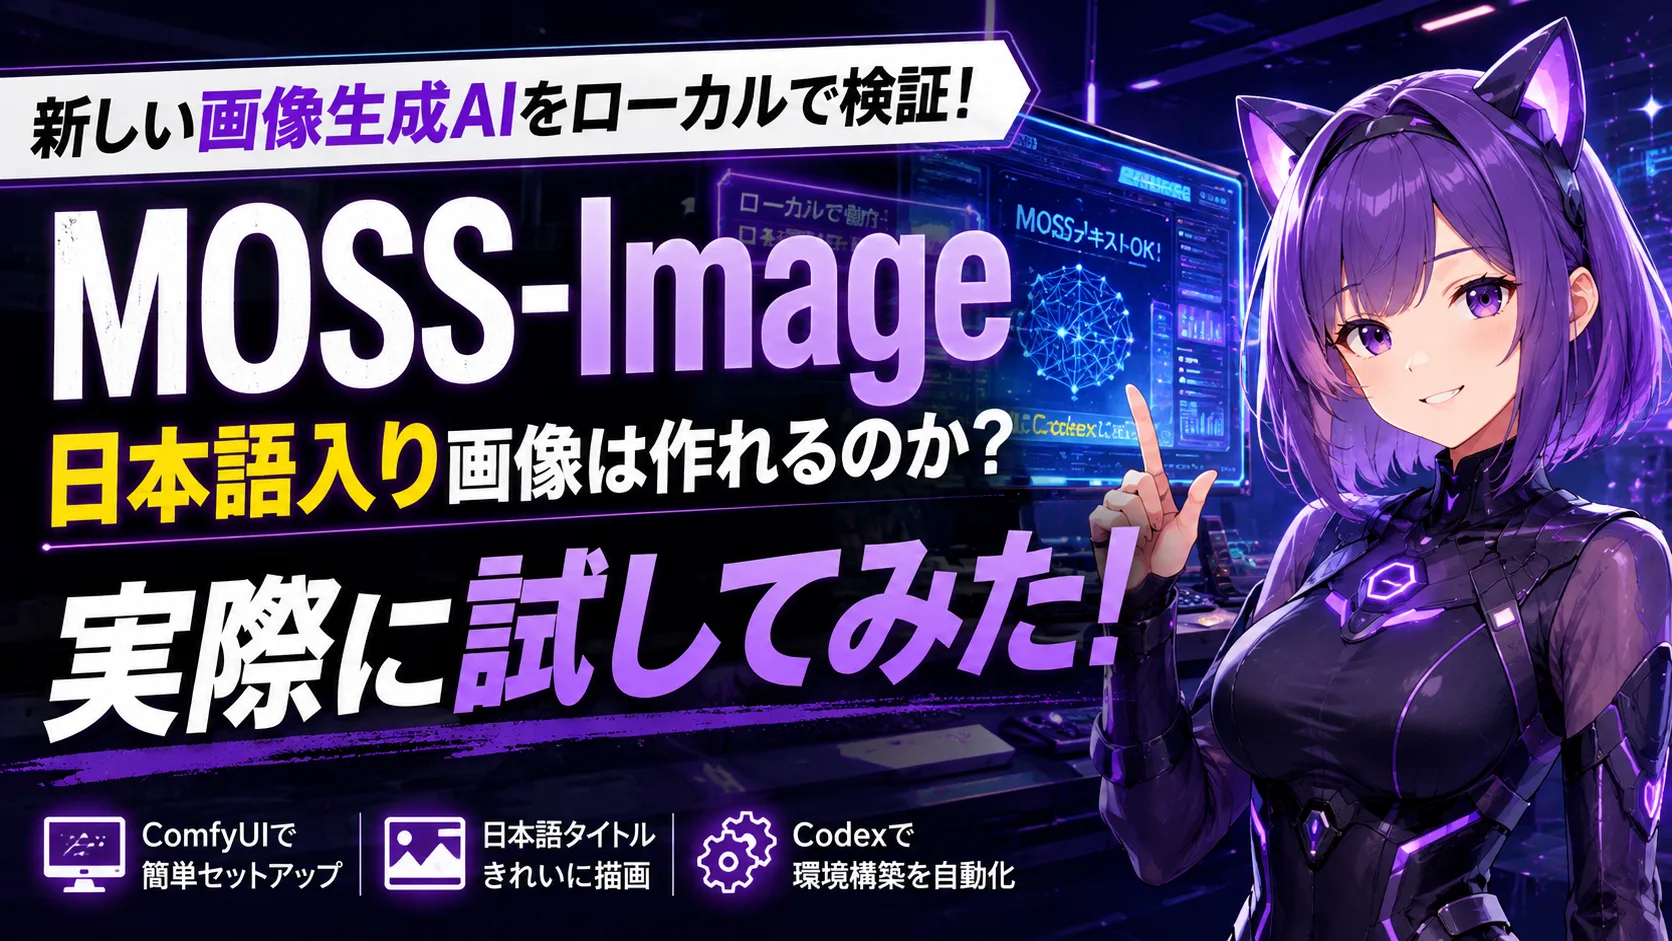
つまり、完成画像のデザインを分析し、再現するための仕様書に近いものを作ってくれました。このJSONを使ってMossImageで画像を生成してみると、ChatGPTで作ったものにかなり近いアイキャッチができました。
こちらが実際の画像です。
上がChatGptにて作成したアイキャッチ画像、下がCodexに作ってもらったプロンプトでMoss Imageで生成したアイキャッチ画像。
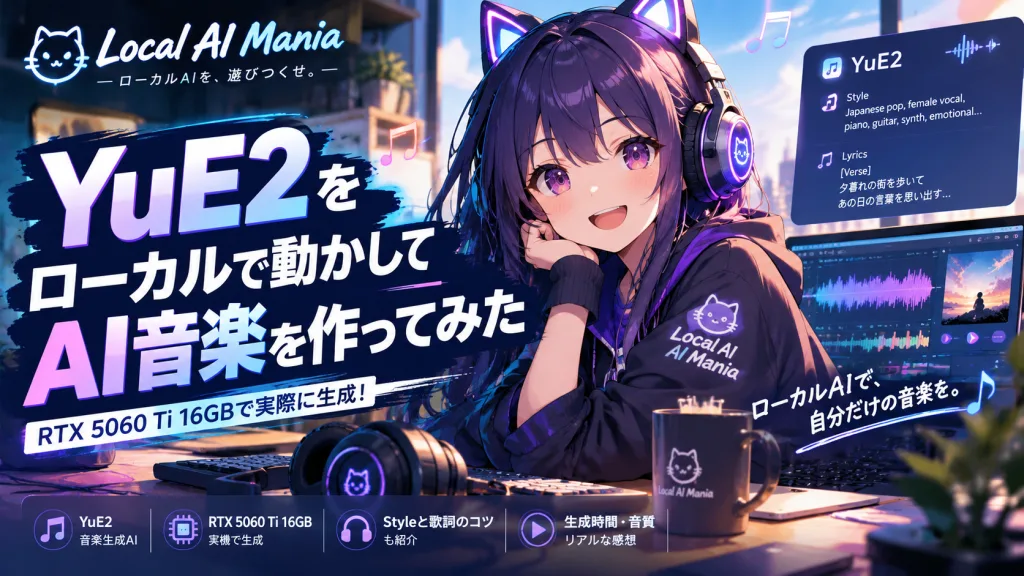
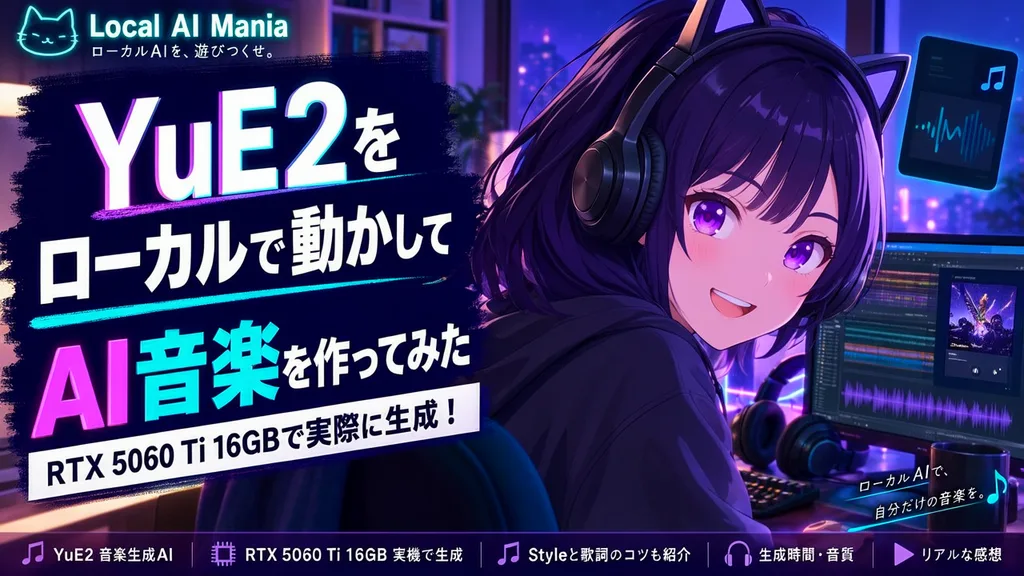
Moss Imageはテキストに強いモデルなので日本語もOKなのは確認済みでしたが、ChatGptで作成したものにだいぶ近い感じで生成できました。
もちろん、毎回同じ品質で再現できるかは検証が必要ですが、それでも一度の指示からここまで具体的な情報を抽出できたことには驚きました。
同じことをGemma 4 12Bで試したら……
実は、ローカルLLMでも同じようなことを試しました。使ったのはいつも使っているGemma 4 12Bです。
ローカルLLMには、まずMoss Imageについて調べてもらい、Codexの時と同じように参考画像を渡して、再現用のプロンプトを作るように指示しました。ところが、最初に出てきたのは文字のない画像でした。
文字を含めて再現したいと指摘すると、今度は「文字は後から追加した方がいい」といった提案が(汗。
いや、そうじゃないんだよなぁ。
こちらが欲しかったのは、文字を含めて完成したアイキャッチを再現するためのプロンプトで、指示した目的に沿って作業を進めてもらいたかったのに、途中で別の解決策に切り替わってしまいました。
一方、Codexでは、文字列や配置まで含む構造化されたJSONが出力され、それを使って実際に画像を生成できました。
正直、この差は大きい。。
モデルにもよると思いますが、やっぱりローカルAIとクラウドAIにはまだまだ大きな差があるな、と感じました。
とはいえ、ローカルAIを使うメリットも確実にあるので任せる作業によって使い分けるのは良いなと思います。
おわりに
今回、CodexとローカルLLMを比較してみて、複雑な指示を理解し、目的に沿って作業を進める能力には、まだ大きな差があると感じました。
もちろん、今回の結果だけでローカルLLM全体の実力を判断できるわけではありません。モデルによって得意不得意がありますし、ローカルAIにも、利用料金を抑えて自由に試せるというメリットがあります。
大切なのは、ローカルAIだけですべてを完結させようとするのではなく、作業の内容に応じて、ローカルAIとクラウドAIを使い分けることなのかもしれません。
ローカルAIへの期待が大きかっただけに、少し残念な部分もありましたが、今後も実際に使いながら、どんな作業に活用できるのか試していきたいと思います。
コメント