Warning: Undefined property: stdClass::$access_token in /home/roukaisen/roukaisen.info/public_html/wp-content/plugins/yyi-rinker/yyi_rinker_main.php on line 2322
「ローカルLLMを動かしてみたいけど、結局どのモデルを選べばいいの?」
「VRAM 16GBのPCなら、どこまでのモデルが現実的なんだろう?」
ローカルLLMを始めようとすると、モデルの種類や量子化、必要なVRAMなど、考えることが意外とたくさんあります。
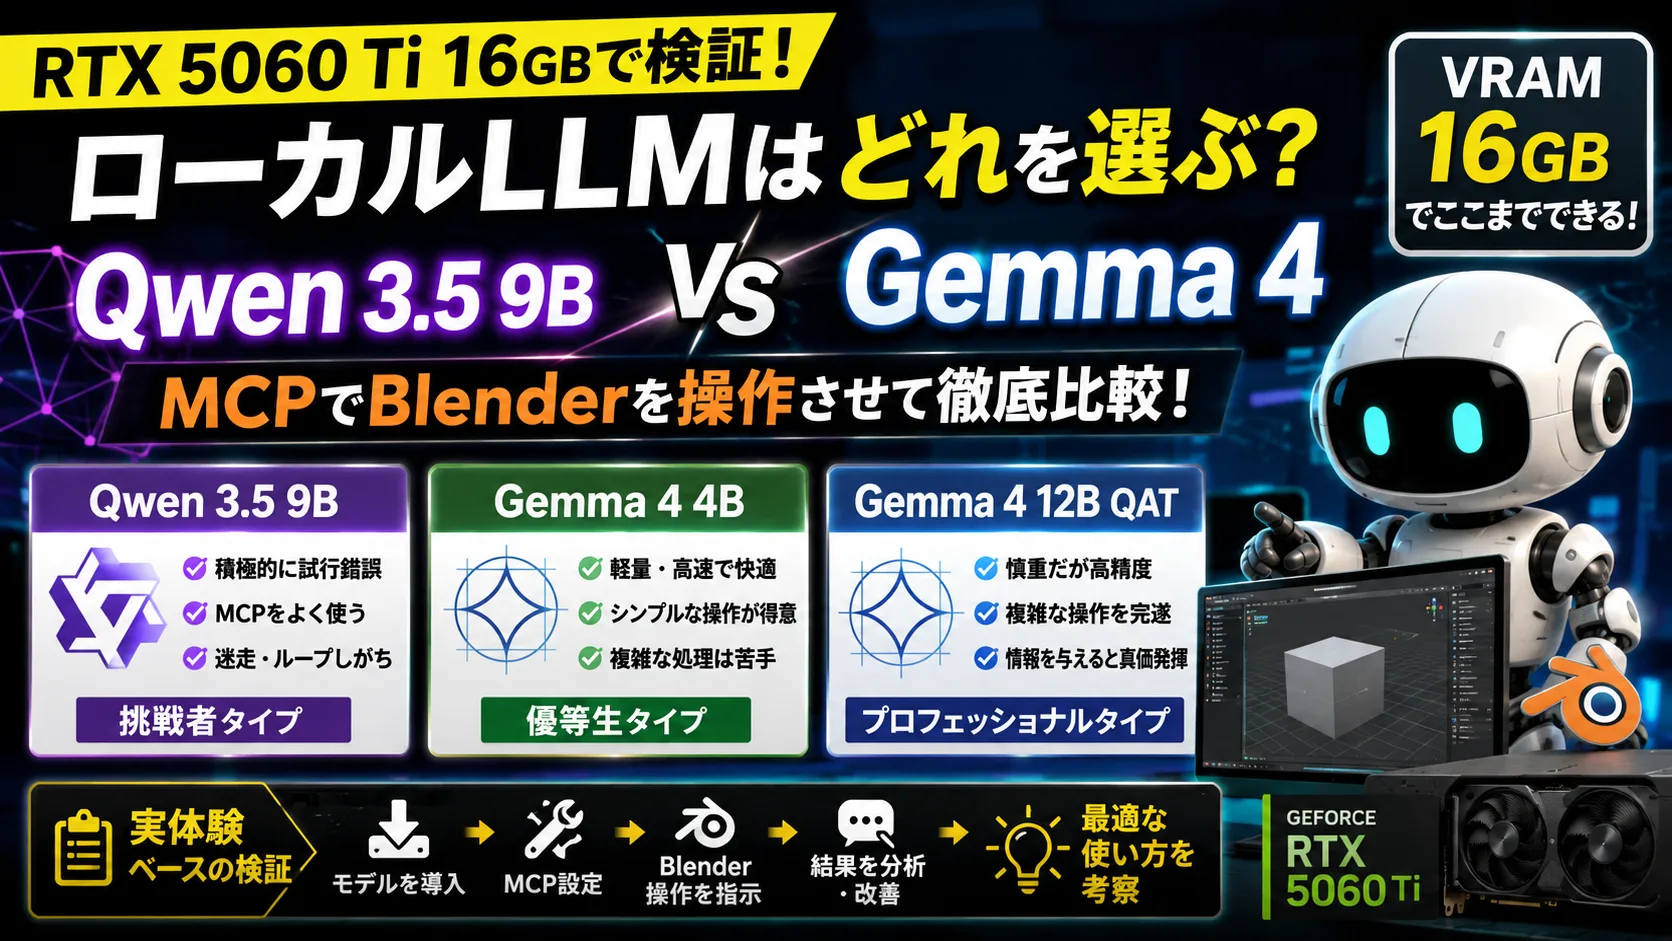
そこで今回は、私の環境で実際に複数のLLMを動かし、MCP(Model Context Protocol)を使ってBlenderを操作させるところまで試してみました。
単純なチャット性能ではなく、
- ツールを正しく呼び出せるか
- 複数の操作を組み合わせられるか
- エラーが出たときに自力で修正できるか
- 途中で同じ処理を繰り返す「ループ」に入らないか
といった、AIエージェントとして使ったときの挙動を中心に比較しています。
先に結論を言うと、今回の環境では「一番賢いモデル」というより、用途によってかなり性格が違うという結果になりました。
今回の検証環境
今回使用したPCはこちらです。
- GPU: NVIDIA GeForce RTX 5060 Ti 16GB
- LLMクライアント: LM Studio
- MCP: Blender MCP
- 検証対象: Blenderの操作
- 検証モデル:
- Gemma 4 4B
- Qwen 3.5 9B
- Gemma 4 12B QAT(GGUF / 量子化版)
今回のポイントは、単純に「質問に答えられるか」ではなく、LLMにツールを渡して実際の作業をさせたことです。
🤖 3つのモデルを実際に使ってみた
① Gemma 4 4B:軽量・高速の優等生
まず試したのがGemma 4 4Bです。このモデルの最大の特徴は、やはり軽さ。
VRAMへの負担が比較的小さく、レスポンスも速いため、ローカルLLMを初めて触る人にも扱いやすいモデルだと感じました。
実際に使ってみると
簡単な指示なら素直に処理してくれます。Blenderで単純なオブジェクトを作るような処理では問題なく動作しました。
一方で、MCPを使って複数の操作を組み合わせたり、状況を判断しながら次の操作を決めたりするような処理になると、少し力不足を感じます。
つまり、
「軽くて速い。でも複雑な仕事を丸ごと任せるには少し厳しい」
という印象です。
こんな人に向いていそう
② Qwen 3.5 9B:積極的だけどたまに迷走する
次に試したのがQwen 3.5です。このモデルは、Gemma 4 4Bとはかなり違った印象でした。
一言で表現するなら、
「とにかく自分から動こうとする」
モデルです。MCPを渡してBlenderを操作させると、かなり積極的にツールを呼び出して問題を解決しようとします。
「これでダメなら別の方法を試そう」という感じで、試行錯誤を続ける場面もありました。これはAIエージェントとして見ると面白いところです。しかし、その積極性が裏目に出ることもありました。
迷走すると止まらない
問題が発生したときに、自分で解決しようとして同じような処理を繰り返してしまうことがあります。
いわゆるループ状態です。人間から見ると、
「いや、それさっきやって失敗したやつだよ!」
ということを、もう一度試してしまう。こうなると、人間側から指示を入れて軌道修正する必要があります。ただし、これは単純な「性能不足」とは少し違います。
むしろ、
「積極的に動こうとするからこそ迷走する」
という印象でした。
こんな人に向いていそう
③ Gemma 4 12B QAT:慎重だけど、条件が揃うと強い
そして今回、一番面白かったのがGemma 4 12B QATでした。最初の印象は、意外にも「慎重」です。こちらがやりたいことを伝えても、
「その操作はできません」
と判断してしまうことがあります。
「いや、できるんだけどな……」
と思うこともありました。ところが、MCPで利用できるAPIや操作方法を具体的に伝えてみると、挙動が大きく変わりました。
利用できる機能を正しく理解させた状態では、複雑な操作をかなり正確に実行できたのです。
今回のBlender MCP検証では、3モデルの中で最も安定して複雑な操作を完遂できたのが、このGemma 4 12B QATでした。
実際の検証で分かったこと
今回の検証は、私一人で最初から答えを決めていたわけではありません。ローカルLLMにMCPを接続し、実際にBlenderを操作させながら、
「なぜここで失敗した?」
「このモデルは何が苦手なんだろう?」
「システムプロンプトを変えたらどうなる?」
「このツールの使い方を明示したら改善する?」
といったことを、ChatGPTと一緒に試行錯誤しながら検証していきました。モデルを入れて終わりではありません。
システムプロンプトを調整したり、利用できるツールを確認したり、エラーの原因を調べたりしながら、少しずつAIエージェントとして動く形に近づけていきました。
この過程で感じたのは、
ローカルAIエージェントは「モデルの性能だけ」で決まるものではない
ということです。
モデル、プロンプト、MCP、ツールの設計、コンテキスト長など、いろいろな要素が組み合わさって結果が決まります。
今回の体感比較
あくまで今回の環境・Blender MCPで使った場合の個人的な評価ですが、ざっくりまとめるとこんな感じです。
| モデル | 軽さ | MCP積極性 | 複雑な操作 | 安定性 | 今回の印象 |
|---|---|---|---|---|---|
| Gemma 4 4B | ◎ | △ | △ | ○ | 軽量・高速 |
| Qwen 3.5 9B | ◎〜○ | ◎ | ○ | △ | 積極的だが迷走することも |
| Gemma 4 12B QAT | ○ | ○ | ◎ | ◎ | 慎重だが条件が揃うと強い |
ここで重要なのは、この表を一般的なLLM性能ランキングとして見ないことです。あくまで、
RTX 5060 Ti 16GB + LM Studio + Blender MCP
という私の環境で実際に使ってみた結果です。
VRAM 16GBならどこまで狙える?
今回の検証を通して感じたのは、
VRAM 16GBは、ローカルLLMを本格的に試すにはかなり面白い容量
ということです。ただし、
「モデルが動く」=「快適に使える」ではありません。
量子化モデルを使えば12Bクラスを動かせても、コンテキストを大量に消費する使い方をすると、途端に余裕がなくなることがあります。
特にMCPを使ったエージェントでは、通常のチャットよりもツールの情報や会話履歴などが増えるため、コンテキスト長が重要になります。
そのため、
VRAM 8GB以下
まずは4Bクラスなど、比較的軽量なモデルから試してみる。
VRAM 12〜15GB
軽量モデルだけでなく、量子化した中規模モデルも候補になります。
VRAM 16GB
12Bクラスの量子化モデルなど、より本格的なローカルAIエージェントを試せる範囲に入ってきます。
ただし、コンテキスト長や量子化方式によって必要なメモリは変わるので、「16GBなら何でも動く」と考えないほうがいいでしょう。
結局、どのモデルを選べばいい?
今回の検証から感じたのは、単純に「このモデルが一番」という話ではないということです。
とにかく軽く動かしたい
→ Gemma 4 4B
まずローカルLLMを体験したいなら、このクラスから始めるのも十分アリです。
AIに積極的に試行錯誤させたい
→ Qwen 3.5
エージェント的に動かしてみたい人には面白いモデルです。ただし、迷走したときに人間が軌道修正する必要があります。
MCPを使って複雑な作業をさせたい
→ Gemma 4 12B QAT
今回の私の環境では、このモデルが最も安定して複雑なBlender操作を完遂しました。ただし、必要な情報をきちんと与えることが重要でした。
ローカルAIを使って分かったこと
今回いろいろなモデルを実際に触ってみて、個人的に一番印象に残ったのは、
「モデルが大きければ、それだけで全部解決するわけではない」
ということでした。軽量モデルでも、単純な作業なら十分役に立ちます。逆に高性能なモデルでも、ツールの使い方を理解できなければ期待通りに動きません。
そして、モデルに適切な情報を与えたり、使えるツールを整理したり、エラーが起きたときに人間が軌道修正したりすることで、同じモデルでもできることが大きく変わります。
今回の検証では、ChatGPTと一緒に試行錯誤しながら環境を調整していきました。
その結果、最初は「ローカルLLMにBlenderを操作させる」という実験だったものが、徐々に自分専用のローカルAIエージェントを作る実験になっていきました。
だからこそ、今回一番感じたのは、
AIに全部任せるのではなく、AIが力を発揮できる環境を人間が作る。
ということです。ローカルLLMは、モデルをダウンロードしてチャットするだけでも楽しめます。
でも、MCPなどで外部ツールと接続すると、そこから一気に「AIを使って何かを作る」世界に入ってきます。
RTX 5060 Ti 16GBくらいのGPUを持っているなら、単なるチャットだけでなく、ローカルAIエージェント作りに挑戦してみるのもかなり面白いですよ。

コメント